GlusterFS の HCI 構成で、仮想マシンを data ドメインに作り、ライブ マイグレーション、ホスト障害時の HA、Gluster のブリック障害と自己修復を確認した手順と結果です。
この記事の前提
参照した公式ドキュメント
- Oracle Linux Virtualization Manager Administrator’s Guide
- Gluster Storage for Oracle Linux User’s Guide
構成
| 項目 | 内容 |
|---|---|
| 環境 | HCI の構築手順で作った 3 台の HCI。エンジン(HostedEngine)は doc-olvm1 で稼働 |
| ストレージ | data ドメイン(GlusterFS、data ボリューム。レプリカ 3、3 台目はアービター) |
| ライブ マイグレーションと Gluster の通信 | gluster ネットワーク(bond0、active-backup) |
| 仮想マシン | rocky-hci01(Rocky Linux 9.8、2 vCPU、メモリー 2 GB、ディスク 20 GB、HA オン・リースは data) |
仮想マシンの作成
仮想マシンの作り方は、3Tier 構成の手順と同じです。違いは、ディスクと VM リースの置き場所に data(GlusterFS)を選ぶことだけです。
| 項目 | 設定値 |
|---|---|
| ディスクの Storage Domain | data |
| Target Storage Domain for VM Lease | data |
| ISO イメージの置き場所 | data(ISO ディスクとしてアップロード) |
この検証では、キックスタートでのインストールに約 10 分 30 秒かかりました(3Tier の iSCSI では約 8 分)。
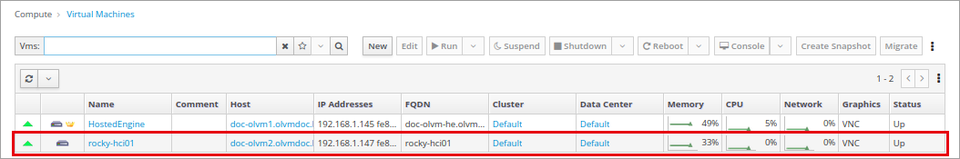
HostedEngine(エンジンの仮想マシン)も一覧に表示されます。HostedEngine は HA エージェント(ovirt-ha-agent)が管理するので、通常の仮想マシンのように停止や削除はしません。
Gluster ボリュームの確認
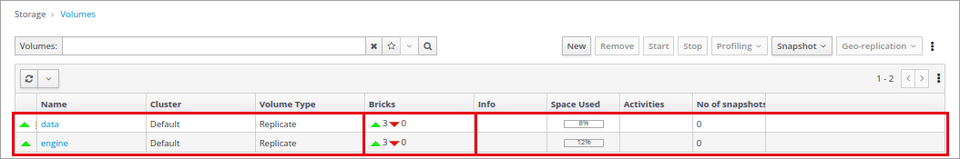
(1) [Storage] → [Volumes] に、Cockpit で作った engine と data が表示されます。[Bricks] 列はオンラインのブリック数(緑)とオフラインのブリック数(赤)です。
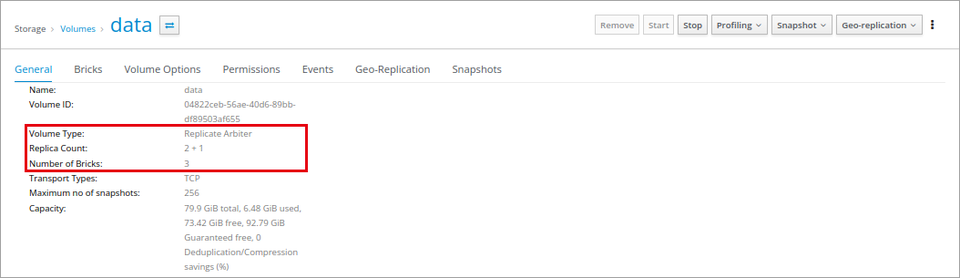
(2) data をクリックすると、[Volume Type] が Replicate Arbiter、[Replica Count] が 2 + 1 であることを確認できます。
ライブ マイグレーション
仮想マシンの [Migrate] で、doc-olvm2 → doc-olvm3 → doc-olvm2 と 2 回移行しました(操作は 3Tier と同じです)。ゲストへ 0.2 秒間隔で ping を送りながら計測しています。
| 項目 | 1 回目(olvm2 → olvm3) | 2 回目(olvm3 → olvm2) |
|---|---|---|
| 所要時間(エンジンのイベント) | 29 秒(Total 39 秒) | 29 秒(Total 39 秒) |
| ping の欠落 | 1 回(約 0.2 秒) | 2 回(約 0.4 秒) |
移行元のホストの vdsm のログでは、移行のデータは gluster ネットワーク(bond0)の IP アドレスに送られています。
grep -oE "tcp://[^ ,']*" /var/log/vdsm/vdsm.log | tail -1tcp://10.20.83.143HA(ホスト障害時の再起動)
仮想マシンが動いている doc-olvm2 の電源を強制的に切りました(エンジンは doc-olvm1 で動いているので影響を受けません)。
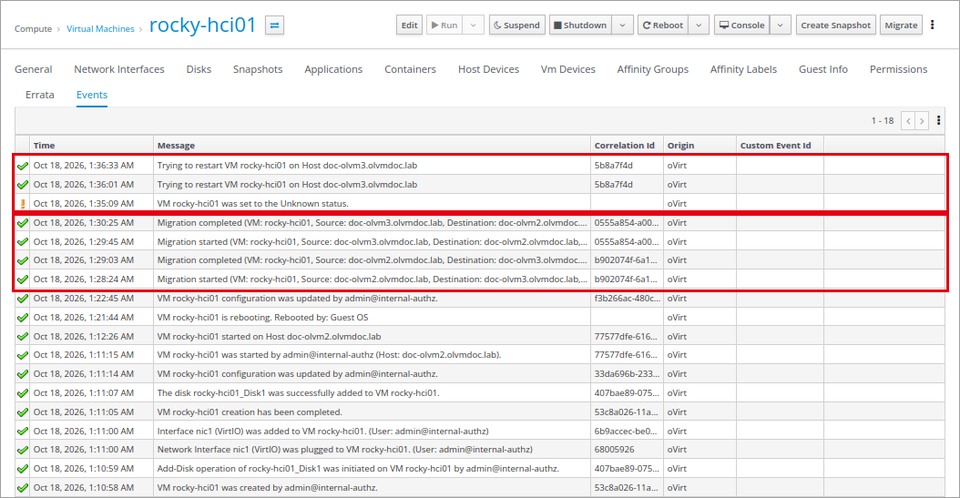
| 経過時間 | 内容 |
|---|---|
| 0 秒 | doc-olvm2 の電源を切る |
| 約 3 分 26 秒 | Host doc-olvm2 is non responsive./VM rocky-hci01 was set to the Unknown status. |
| 約 4 分 18 秒 | Trying to restart VM rocky-hci01 on Host doc-olvm3(1 回目) |
| 約 4 分 50 秒 | Trying to restart VM rocky-hci01 on Host doc-olvm3(2 回目) |
| 約 5 分 9 秒 | ゲストに SSH で接続できる(doc-olvm3 で起動) |
3Tier 構成(約 2 分 54 秒)よりも時間がかかりました。ホストが Connecting のまま約 3 分半続き、Non Responsive と判定されるまでが長かったためです。電源管理(フェンシング)を設定していないので、VM リースの期限が切れてから別のホストで起動しています。
doc-olvm2 が止まっている間も、data ボリュームは doc-olvm1 のブリックと doc-olvm3 のアービターで書き込みを続けました(レプリカ 3 の過半数が残るため)。停止中に書き込まれた分は自己修復の対象として記録され(data 28 件、engine 86 件)、doc-olvm2 を起動すると自動で修復されました。
gluster volume heal data info summaryブリック障害と自己修復
ホストは動かしたまま、doc-olvm2 の data ブリックのプロセス(glusterfsd)だけを止めて、仮想マシンの書き込みと修復を確認しました。
(1) ブリックのプロセスを停止します(試験のための操作です)。
# doc-olvm2 で実行
kill -9 $(pgrep -f "glusterfsd.*gluster_bricks/data/data")
gluster volume status data detail | grep -E "^Brick |^Online"Brick : Brick doc-olvm2-gl.olvmdoc.lab:/gluster_bricks/data/data
Online : N(2) この状態で、仮想マシンの中で 500 MB を書き込みました(direct I/O)。書き込みはエラーなく完了しました(88 MB/s)。残りのブリックには、修復が必要なエントリーが記録されます。
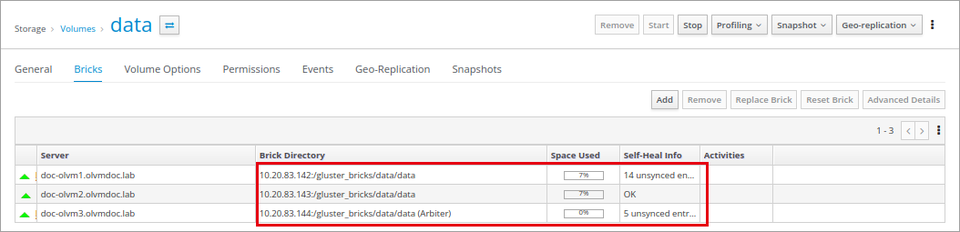
[Bricks] タブの [Self-Heal Info] に、未同期のエントリー(unsynced entries)の数が表示されます。[Brick Directory] は gluster ネットワーク(bond0)の IP アドレスになっています。管理ポータルの状態は定期的に更新されるため、表示が遅れることがあります。
(3) 停止したブリックを起動し直します。
gluster volume start data force(4) 自己修復デーモンが自動で修復します。この検証では、ブリックを起動してから約 5 秒で修復が完了し(52 件 → 0 件)、各ブリックの使用量が一致しました。
gluster volume heal data info summary
du -sm /gluster_bricks/data/data/   # 各ホストで
Total Number of entries: 0
Number of entries in split-brain: 0
doc-olvm1 5635 MB
doc-olvm2 5635 MB
doc-olvm3 1 MB (アービターはメタデータのみ)結果のまとめ
| 試験 | 結果 |
|---|---|
| ライブ マイグレーション | 29 秒、ping の欠落 0.2〜0.4 秒。移行は bond0 経由 |
| HA(ホストの電源断) | 約 5 分 9 秒で別のホストで起動(電源管理なし、VM リースで判定) |
| ブリック障害 | 書き込みは継続。ブリックの再起動から約 5 秒で自己修復が完了 |

