Harvester の HCI ストレージ(Longhorn、レプリカ 3)にクラウド イメージを登録して仮想マシンを作り、ライブ マイグレーション、ボンドの NIC 障害、ノードの電源断(HA)を確認した手順と結果です。
この記事の前提
- ストレージ ネットワークと VM ネットワークの設定が終わっていること
- 参照: Live Migration
イメージの登録
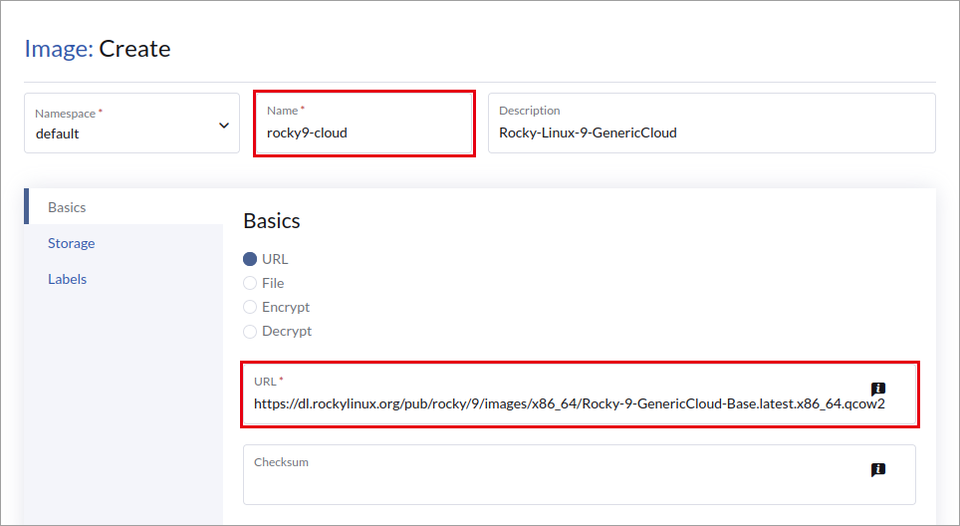
(1) [Images] で [Create] をクリックし、名前を入力して [URL] にクラウド イメージの URL を入力します(ここでは Rocky Linux 9 の GenericCloud)。ノードがインターネットに出られないときは [File] で PC からアップロードします。
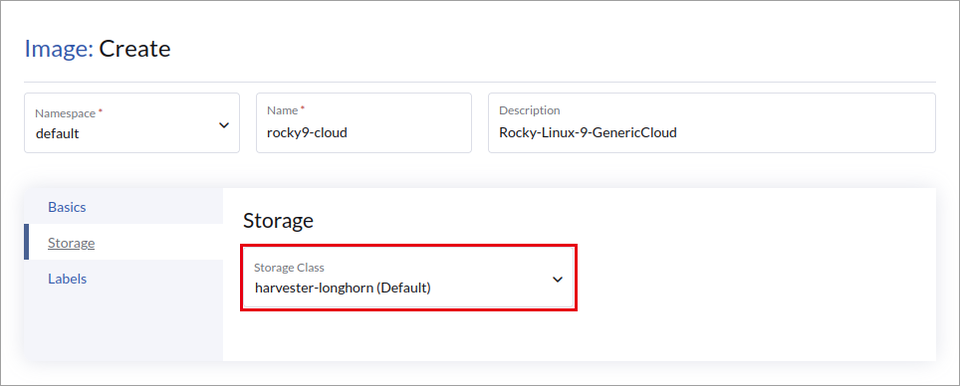
(2) [Storage] でイメージを置くストレージ クラスを確認して [Create] をクリックします。既定の harvester-longhorn はレプリカ 3 です。
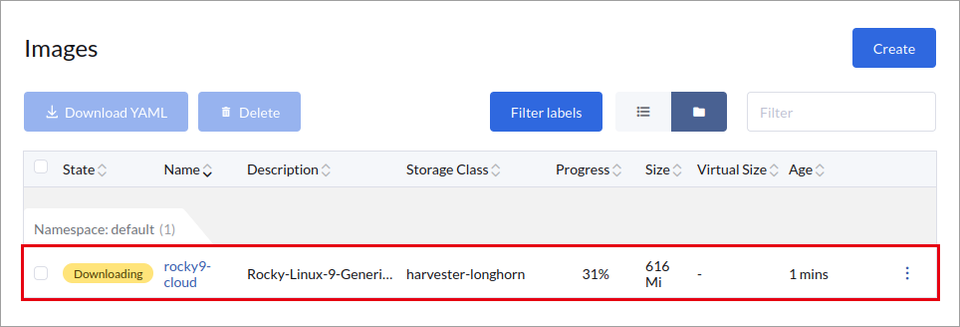
(3) ダウンロードが進み、Active になれば使えます。
仮想マシンの作成
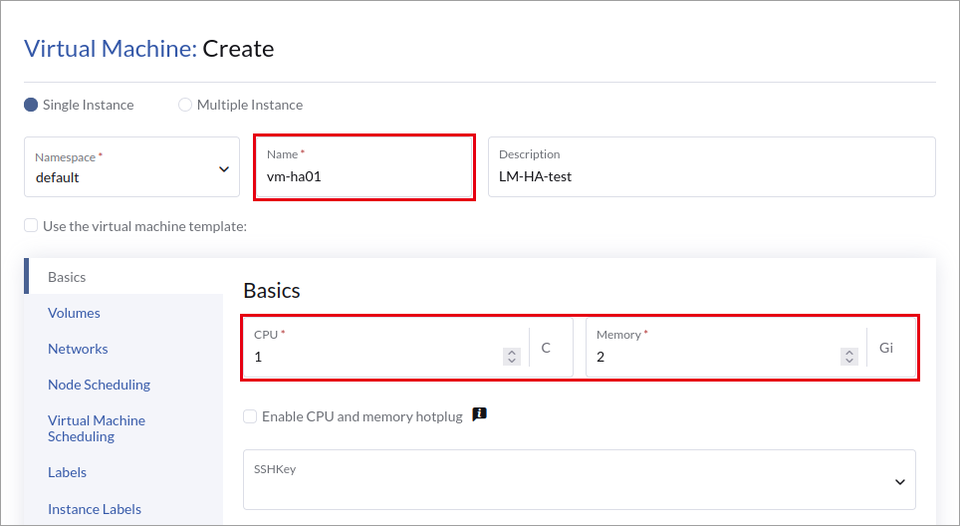
(1) [Virtual Machines] で [Create] をクリックし、名前、CPU、メモリーを入力します。
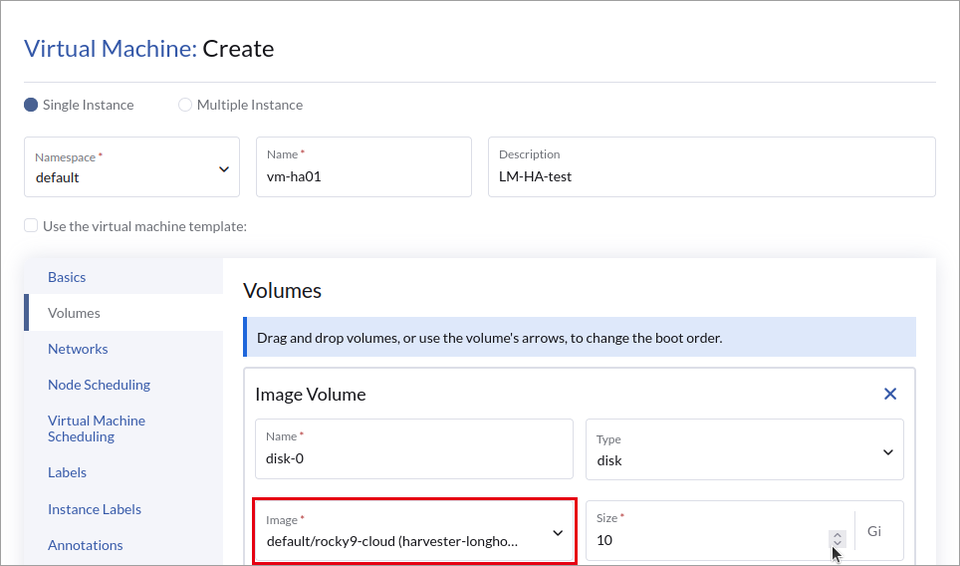
(2) [Volumes] の [Image] で登録したイメージを選びます。ディスクはイメージから作られ、イメージと同じストレージ クラス(レプリカ 3)になります。
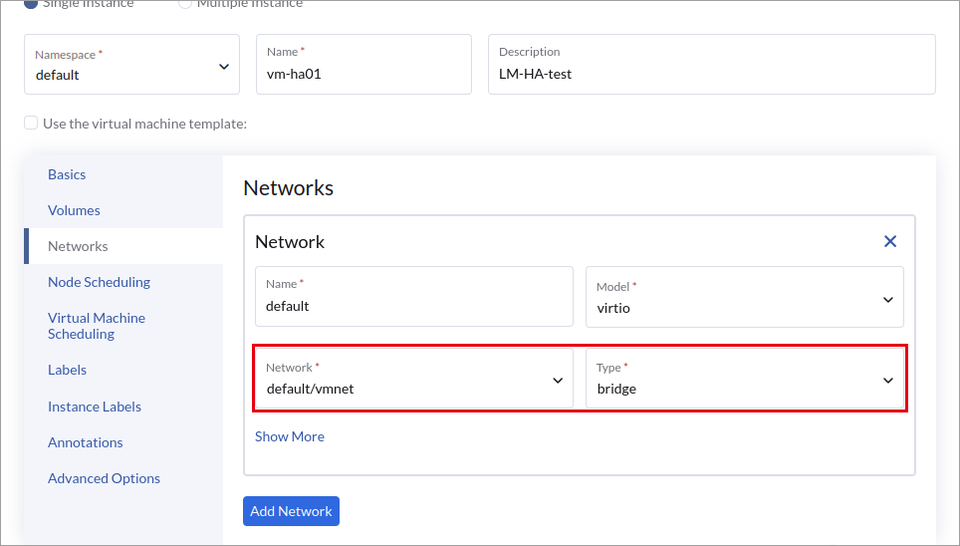
(3) [Networks] の [Network] で VM ネットワーク(default/vmnet)を選びます。Type は bridge になります。既定の management Network(masquerade)は NAT で、外から仮想マシンに直接つなげません。
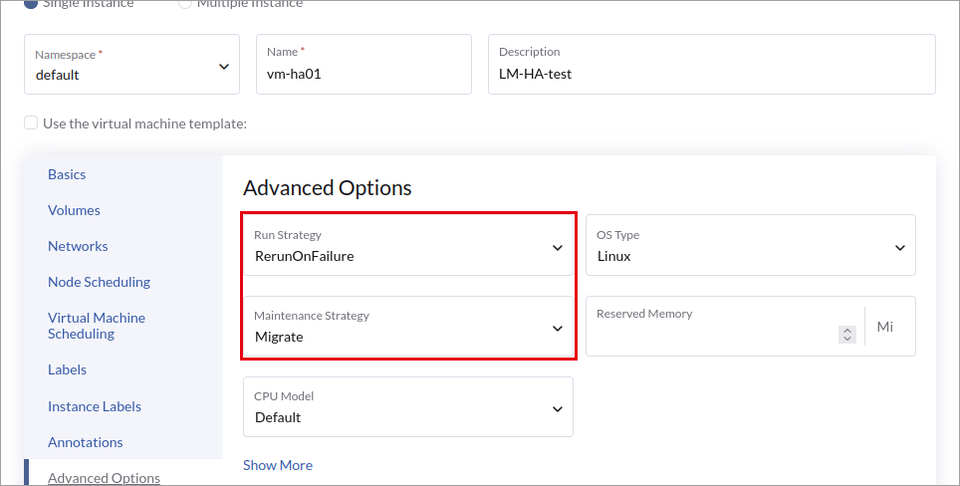
(4) [Advanced Options] で [Run Strategy] が RerunOnFailure(落ちたら再起動)、[Maintenance Strategy] が Migrate(ホストの保守ではライブ マイグレーション)になっていることを確認します。
(5) [User Data] に cloud-init の設定を書きます。ここでは既定ユーザー(rocky)のパスワードと、QEMU ゲスト エージェントのインストールを設定しました。
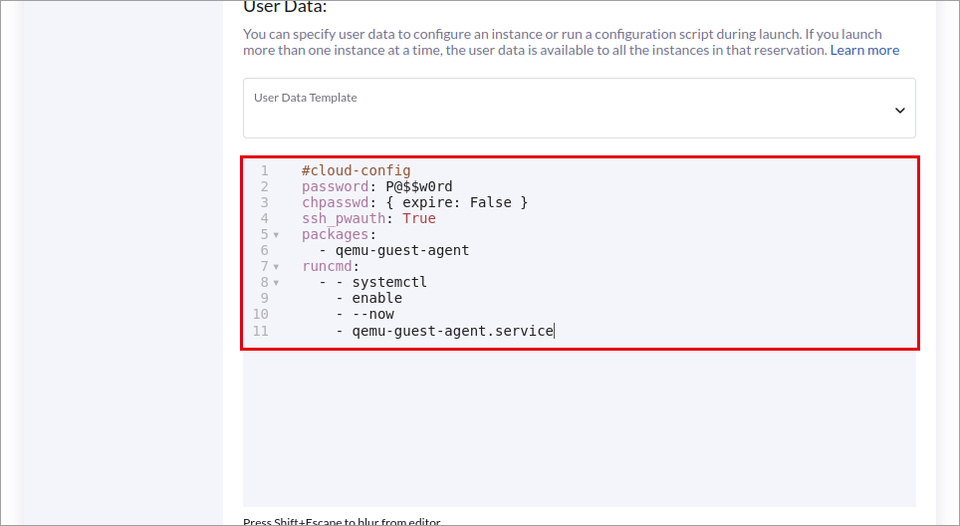
#cloud-config
password: P@$$w0rd
chpasswd: { expire: False }
ssh_pwauth: True
packages:
  - qemu-guest-agent
runcmd:
  - - systemctl
    - enable
    - --now
    - qemu-guest-agent.service
(6) [Network Data] に固定 IP の設定を書いて [Create] をクリックします。
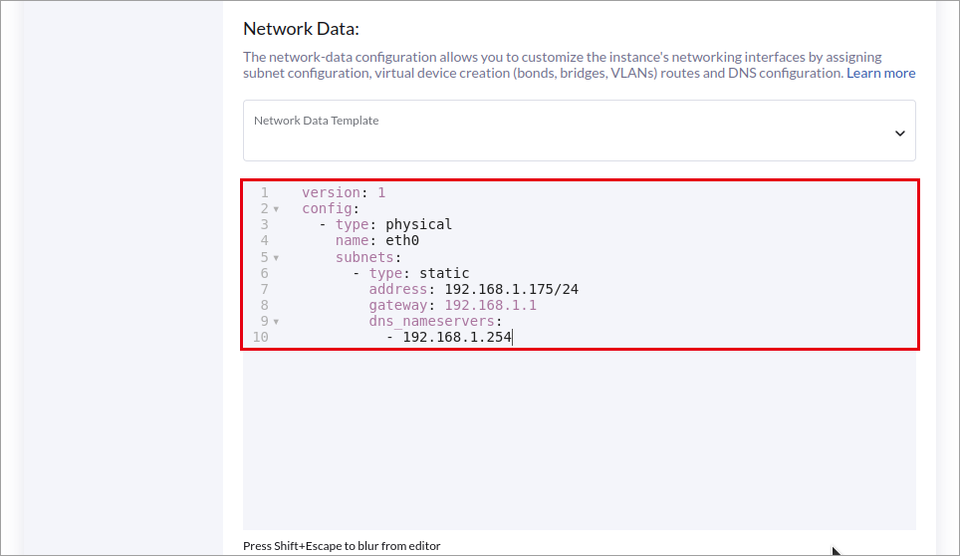
version: 1
config:
  - type: physical
    name: eth0
    subnets:
      - type: static
        address: 192.168.1.175/24
        gateway: 192.168.1.1
        dns_nameservers:
          - 192.168.1.254
最初は network-config version 2 の
match: {name: "e*"}で書きましたが、Rocky Linux 9 の cloud-init(sysconfig レンダラー)は MAC アドレスのない match を扱えず、DHCP のままになりました。インターフェース名(eth0)を直接書く version 1 にすると反映されました。network-config は初回起動でだけ適用されるため、直すときは仮想マシンを作り直します。
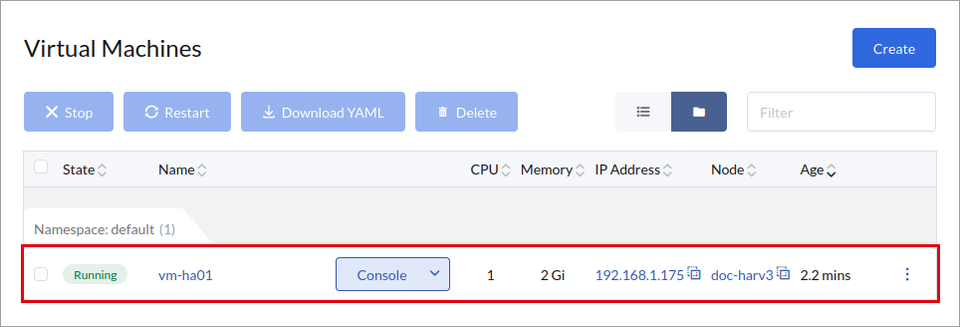
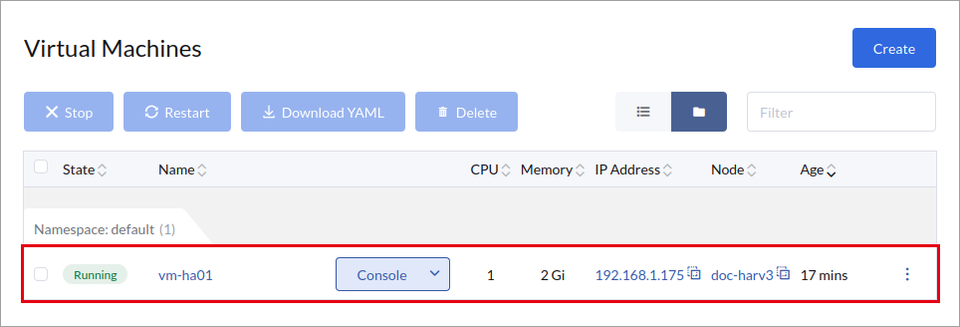
(7) 仮想マシンが Running になり、IP アドレスとノードが表示されます。
レプリカの確認
実行する場所:いずれかのノード(kubectl は前の記事と同じ)
$ kubectl -n longhorn-system get volumes.longhorn.io -o custom-columns=NAME:.metadata.name,STATE:.status.state,ROBUST:.status.robustness,NODE:.status.currentNodeID,REPL:.spec.numberOfReplicas
$ kubectl -n longhorn-system get replicas.longhorn.io -o custom-columns=VOL:.spec.volumeName,NODE:.spec.nodeID,STATE:.status.currentState
期待する出力(抜粋):
NAME                                       STATE      ROBUST    NODE        REPL
pvc-210c7c0e-...                           attached   healthy   doc-harv3   3
VOL                 NODE        STATE
pvc-210c7c0e-...    doc-harv1   running
pvc-210c7c0e-...    doc-harv3   running
pvc-210c7c0e-...    doc-harv2   running
レプリカが 3 台のノードに 1 つずつ置かれています。
ライブ マイグレーション
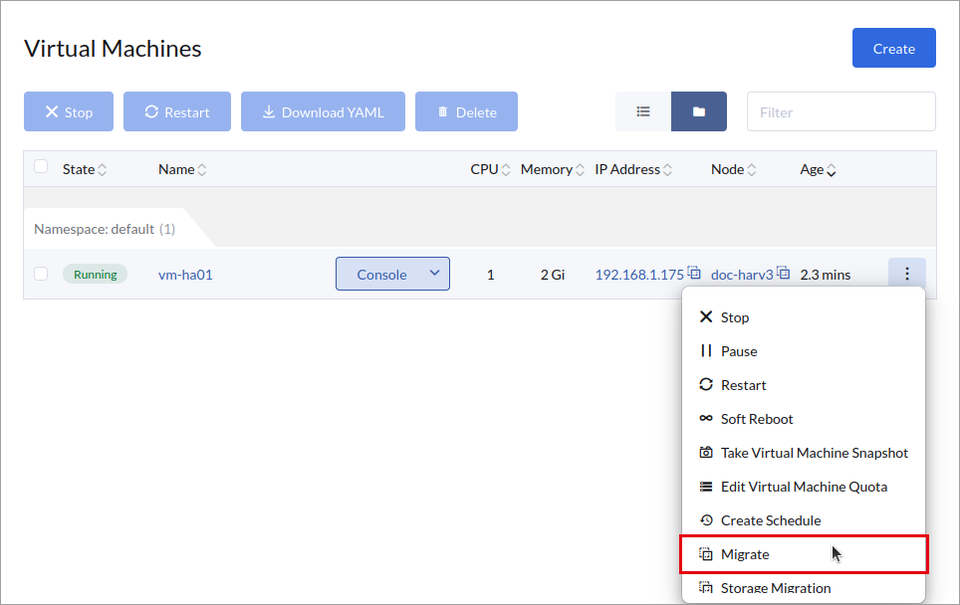
(1) 仮想マシンの︙から [Migrate] をクリックします。
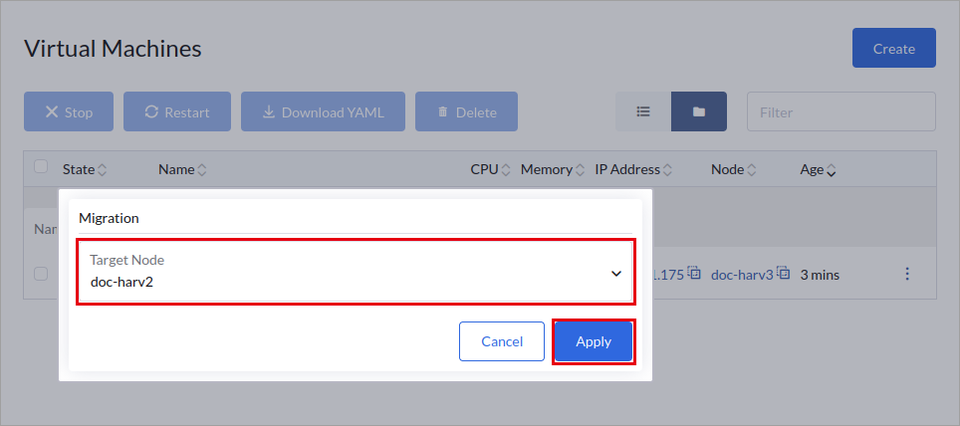
(2) [Target Node] で移動先のノードを選び、[Apply] をクリックします。
(3) State が Migrating になり、終わると Running に戻ってノードが変わります。
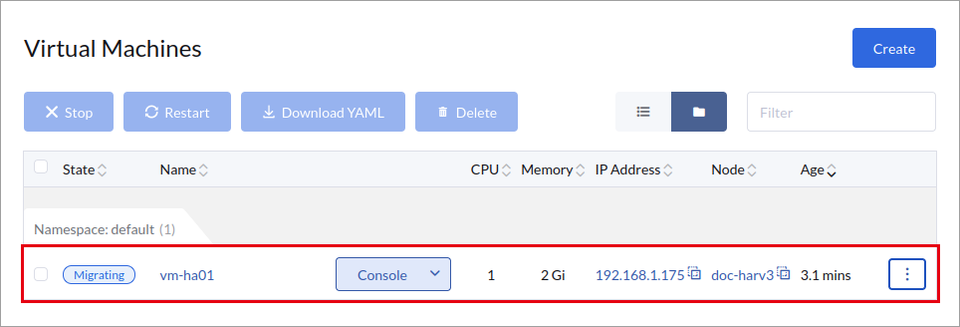
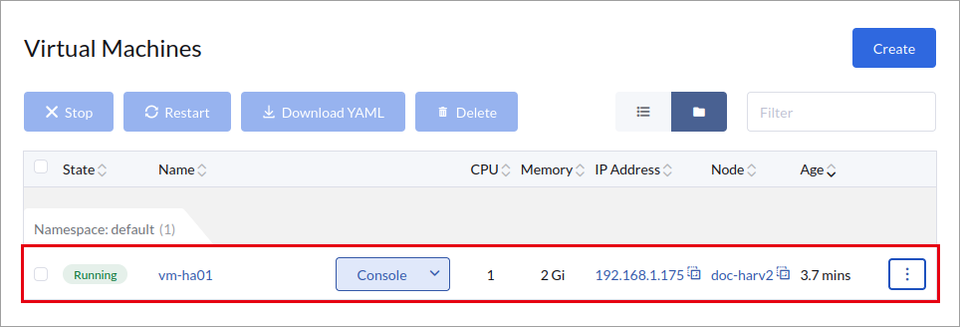
| 項目 | 結果(3 回) |
|---|---|
| 転送(migrationState の開始〜終了) | 8 秒・6 秒・6 秒 |
| ping の最長の途切れ(0.2 秒間隔) | 1.0 秒・0.8 秒・7.6 秒 |
| ゲスト | 再起動なし(ライブ移行) |
1 回だけ 7.6 秒途切れました。3Tier(NFS)の記事でも同じように 1 回だけ長くなっており、ストレージではなくネットワーク側(入れ子の環境の外側のブリッジが、仮想マシンの MAC アドレスを移動先で学び直すまで)の待ちと考えられます。
NIC 障害(ボンドの片側のリンク断)
仮想マシンが動いているノード(doc-harv2)の NIC のリンクを、仮想化基盤の側で切りました。
管理ボンド(mgmt-bo)
稼働側の ens18 を切ると、ens19 に切り替わります。
実行する場所:doc-harv2(rancher ユーザー)
$ grep -E 'Currently Active|^Slave Interface|^MII Status' /proc/net/bonding/mgmt-bo期待する出力(ens18 を切った後):
MII Status: up
Currently Active Slave: ens19
Slave Interface: ens18
MII Status: down
Slave Interface: ens19
MII Status: up| 項目 | 結果 |
|---|---|
| ノードの管理 IP(.173)への ping | 欠落なし |
| 仮想マシンへの ping(仮想マシンから外へ通信しているとき) | 1 回(0.4 秒)の欠落 |
| 仮想マシンへの ping(仮想マシンが何も送信していないとき) | 42.8 秒途切れた |
仮想マシンが送信していないと、外側のスイッチ(この検証では Proxmox VE のブリッジ)が仮想マシンの MAC アドレスを切れた側のポートで覚えたままになり、ARP を引き直すまで届きませんでした。物理のスイッチではポートのリンク ダウンで MAC アドレスの表が消えるため、この待ちは起きにくくなります。入れ子の環境で試すときは注意してください。
ストレージ ボンド(storage-bo)
仮想マシンの中で 3 GB の書き込み(dd、oflag=direct)を続けながら、稼働側の ens21 を切りました。
| 項目 | 結果 |
|---|---|
| ボンド | ens20 に切り替わった |
| 書き込み | 止まらずに完了(84.9 MB/s。障害なしのときと同程度) |
| ボリューム | healthy のまま(レプリカの再構築なし) |
| 仮想マシンへの ping | 欠落なし |
HA(ノードの電源断)
仮想マシンが動いている doc-harv2 の電源を強制的に切りました。
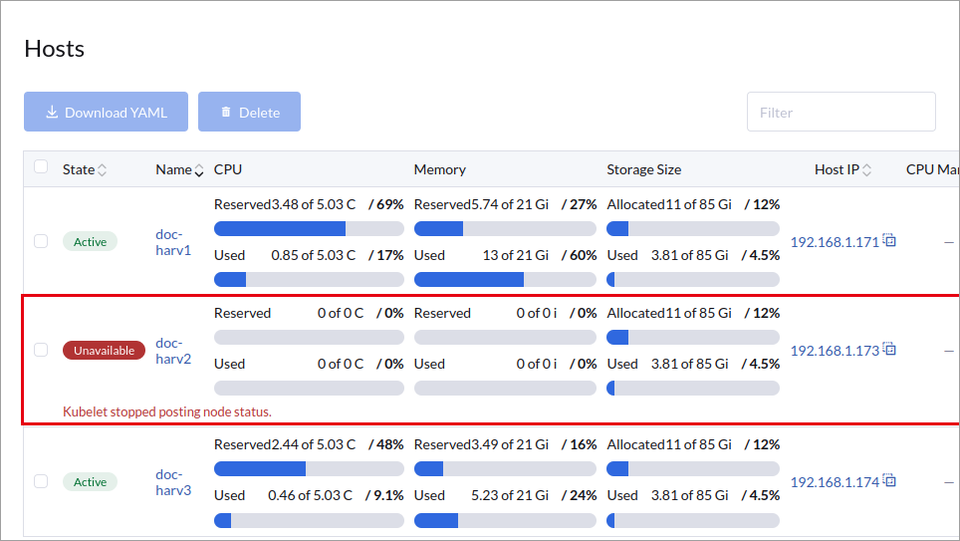
(1) [Hosts] で doc-harv2 が Unavailable(Kubelet stopped posting node status)になります。
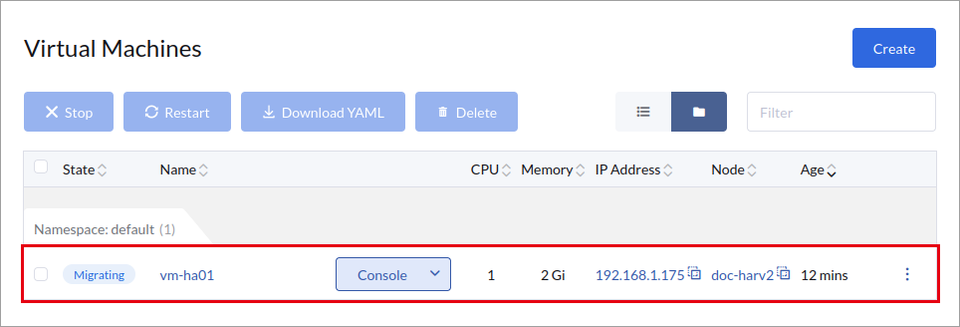
(2) 仮想マシンは、いったん退避のマイグレーション(Migrating)が試みられます。止まったノードからは移せないため、タイムアウトの後に別のノードで起動し直します。
(3) 別のノード(doc-harv3)で Running になります。
| 経過(電源断から) | 状態 |
|---|---|
| 52 秒 | ノードが NotReady |
| 261 秒 | 仮想マシンの再スケジュール開始 |
| 295 秒 | doc-harv3 で Running |
| 339 秒 | ゲストが起動し ping が通った(途切れは 338 秒) |
この動きは設定 vm-force-reset-policy([Advanced] → [Settings])で決まります。既定は {"enable":true,"period":15,"vmMigrationTimeout":180} で、ノードが NotReady になってから 15 秒後に退避を試み、180 秒で打ち切って別のノードで起動します。止まるまでの時間を短くしたいときは vmMigrationTimeout を小さくします。
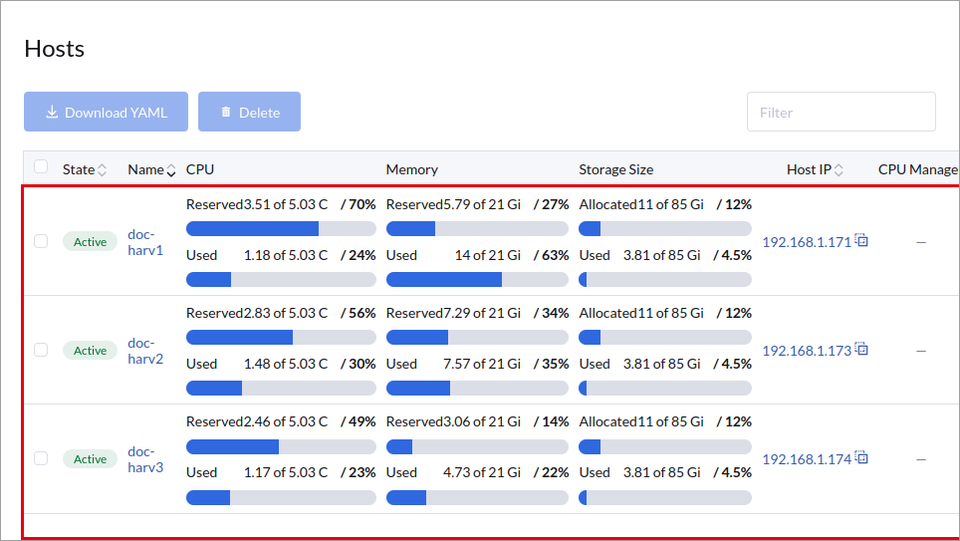
(4) doc-harv2 の電源を入れると、ノードが戻り、レプリカが作り直されます。
| 経過(電源投入から) | 状態 |
|---|---|
| 88 秒 | ノードが Ready |
| 148 秒 | doc-harv2 のレプリカが running(再構築) |
| 171 秒 | ボリュームが healthy に戻った |
結果のまとめ
| 試験 | 結果 |
|---|---|
| ライブ マイグレーション | 転送 6〜8 秒、ping の途切れは多くが 1 秒以内 |
| 管理ボンドの NIC 障害 | ノードは無停止、仮想マシンは 0.4 秒 |
| ストレージ ボンドの NIC 障害 | 無停止(書き込み・ボリュームとも影響なし) |
| ノードの電源断(HA) | 338 秒で別のノードで再起動(既定の vm-force-reset-policy) |
| ノードの復旧 | 電源投入から 171 秒でボリュームが healthy |

