3 台の HVM ホストのローカル ディスクで Ceph を構成する HCI クラスタ(HVM 1.3 HCI Ceph Cluster)を作り、仮想マシンのライブ マイグレーション、ストレージ ネットワーク(ボンド)の NIC 障害、ホストの電源断と Ceph の回復を確認した手順と結果です。
この記事の前提
- VME Manager は3Tier の記事で展開したものを使い、2 つ目のクラスタとして HCI クラスタを作ります。
- 参照: HPE Morpheus VM Essentials Software Documentation v9.1.0(Hardware Requirements、Provisioning the Cluster)
| 項目 | 内容 |
|---|---|
| レイアウト | HVM 1.3 HCI Ceph Cluster on HVM/Ubuntu 24.04(Ceph の HCI は 1.3 レイアウトのみ。3 ノード以上) |
| ホスト | doc-hci1〜3(192.168.1.154〜156)。HVM OS 24.04(HPE_HVM_Install_24.04_S5Q83-11092.iso) |
| ディスク | sda 40 GB(OS)、sdb 100 GB(Ceph のデータ ディスク) |
| ネットワーク | ens18(管理・VM)、bond0=ens19+ens20(active-backup、10.20.86.x、Ceph 用) |
| メモリー | 各 10 GB(Ceph のディスク 1 本あたり 4 GB 以上が要件) |
ドキュメントでは、Ceph のデータ ディスクは検証でも 500 GB 以上、ネットワークは 10 Gbps 以上(ジャンボ フレーム)が推奨されています。この検証は入れ子の仮想環境のため、小さい構成で行いました。
ホストの準備
HVM OS 24.04 を 3 台にインストールします。画面の流れは 26.04 のインストールと同じです。1.3 レイアウトでは、ホストのネットワーク(ボンドなど)はインストール時またはその後に netplan で用意しておきます。この検証では、インストール時に Ceph 用の bond0 を作りました。
# /etc/netplan の設定(抜粋)
  bonds:
    bond0:
      interfaces: [ens19, ens20]
      addresses: [10.20.86.154/24]
      parameters:
        mode: active-backup
        mii-monitor-interval: 100
Ceph 用のディスク(sdb)が OS ディスクより大きい場合、無人インストールの「direct」レイアウトは大きい方のディスクに OS を入れます。OS ディスクを明示して(この検証では
match: size: smallest)インストールしてください。
HCI クラスタの作成
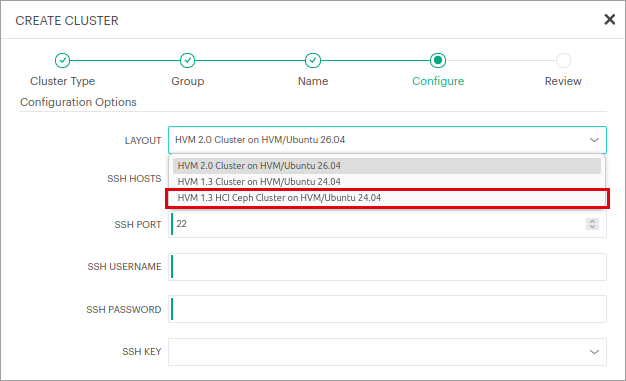
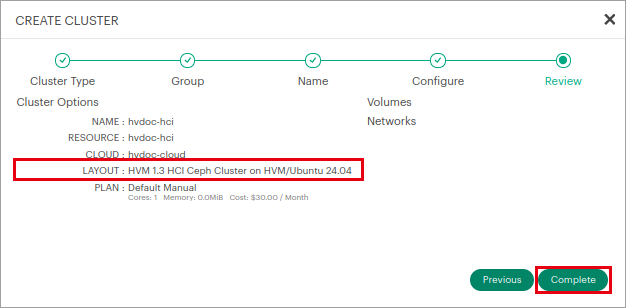
(1) [Infrastructure] → [Clusters] → [+ Add Cluster] → [HVM] → グループ → 名前(hvdoc-hci)と進み、[Configure] の [LAYOUT] で [HVM 1.3 HCI Ceph Cluster on HVM/Ubuntu 24.04] を選びます。
(2) ホストと HCI の項目を入力します。
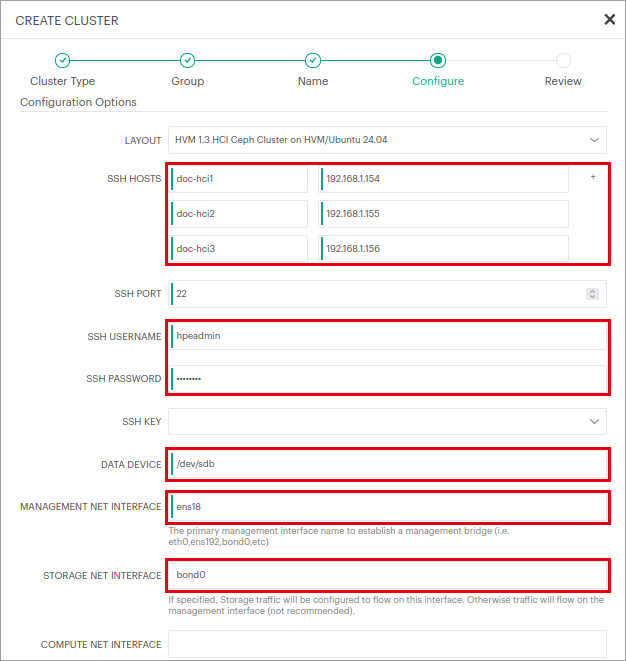
| 項目 | 説明 | 設定値 |
|---|---|---|
| SSH HOSTS | 3 台以上のホスト | doc-hci1〜3/192.168.1.154〜156 |
| SSH USERNAME/PASSWORD | sudo が使えるユーザー | hpeadmin/インストール時のパスワード |
| DATA DEVICE | Ceph に使うディスク(複数ならカンマ区切り) | /dev/sdb |
| MANAGEMENT NET INTERFACE | 管理ブリッジを作る NIC | ens18 |
| STORAGE NET INTERFACE | Ceph の通信に使う NIC(空欄だと管理 NIC を使う。非推奨) | bond0 |
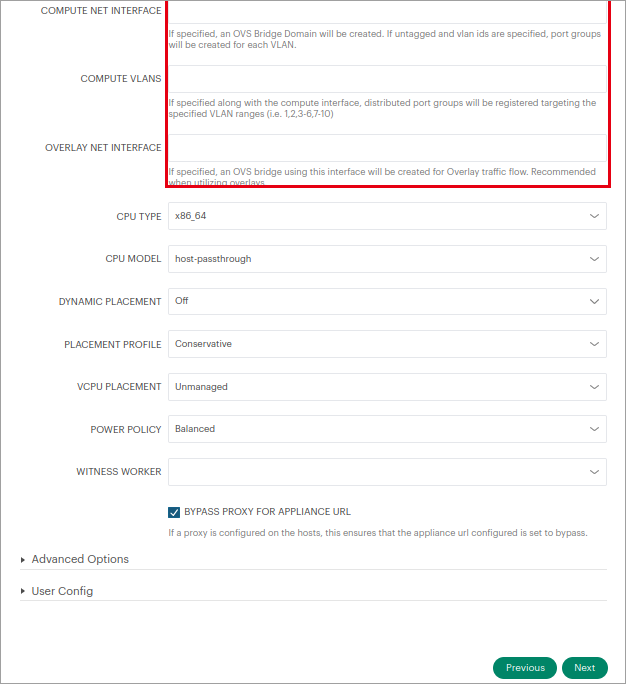
(3) [COMPUTE NET INTERFACE](VM 用の OVS ブリッジ)と [OVERLAY NET INTERFACE] は、この検証では空欄にしました(VM は管理ブリッジに接続)。そのほかは既定値のまま [Next] をクリックします。
(4) 確認して [Complete] をクリックします。
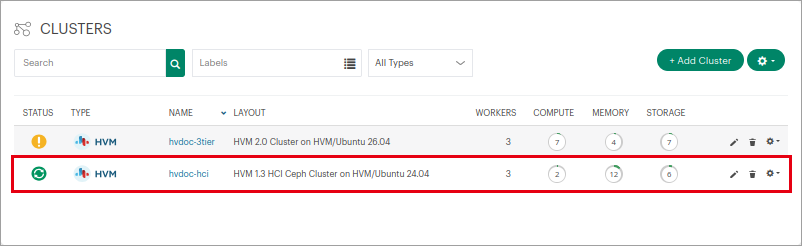
(5) この環境では約 9 分でクラスタが Ok になりました(KVM・OVS・Ceph のインストールを含む)。
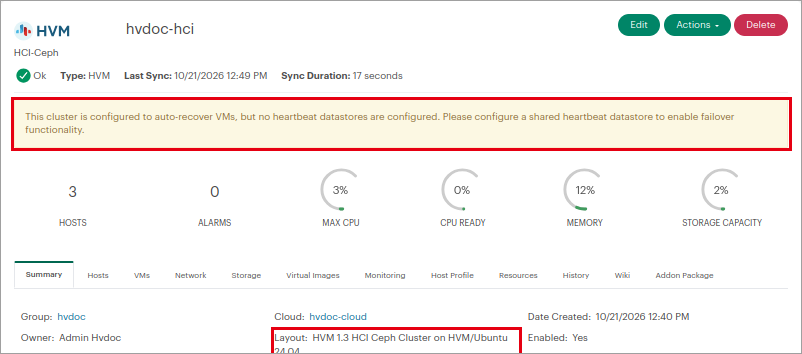
(6) 詳細画面の [Layout] が HCI Ceph になっています。3Tier と同じく、ハートビート用データストアの警告が出ます。
ホストで Ceph の状態を確認すると、MON・MGR・OSD が 3 台に配置され、HEALTH_OK です。MON は bond0(10.20.86.x)で通信しています。
sudo ceph -s
sudo ceph mon dump | grep mon.
health: HEALTH_OK
mon: 3 daemons, quorum doc-hci1,doc-hci3,doc-hci2
mgr: doc-hci1(active), standbys: doc-hci3, doc-hci2
mds: 1/1 daemons up, 2 standby
osd: 3 osds: 3 up, 3 in
0: [v2:10.20.86.154:3300/0,v1:10.20.86.154:6789/0] mon.doc-hci1データストアとハートビート
(1) [Storage] タブには、Ceph の RBD プール(mvm-volumes、mvm-image-cache)が自動で作られています。どちらもレプリカ 3(min_size 2)です。
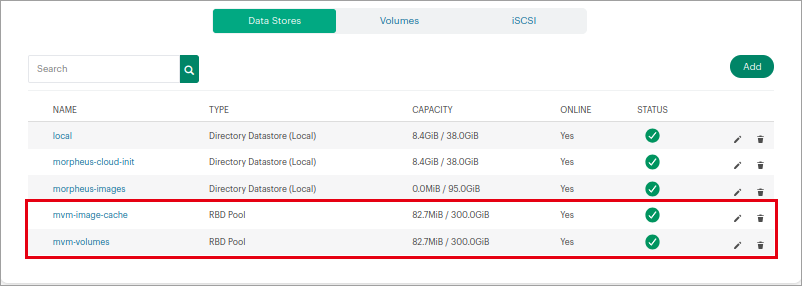
| データストア | 内容 |
|---|---|
| mvm-volumes | 仮想マシンのディスク(RBD) |
| mvm-image-cache | イメージのキャッシュ(RBD) |
| morpheus-images | 全ホストで CephFS(mvm-virtual-images)をマウントした共有ディレクトリ |
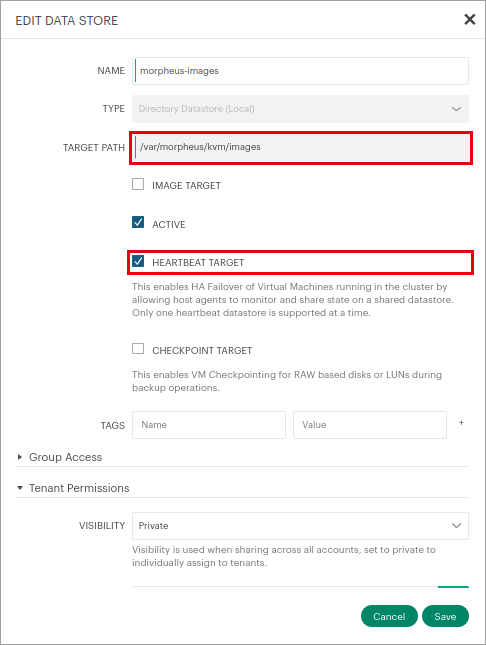
(2) RBD プールにはハートビートの設定がないので、共有の morpheus-images(/var/morpheus/kvm/images)を編集し、[HEARTBEAT TARGET] をオンにします。
仮想マシンの作成
作り方は 3Tier の記事と同じです。[RESOURCE POOL] に HCI クラスタ(hvdoc-hci)、ボリュームの置き場に mvm-volumes を選びます。
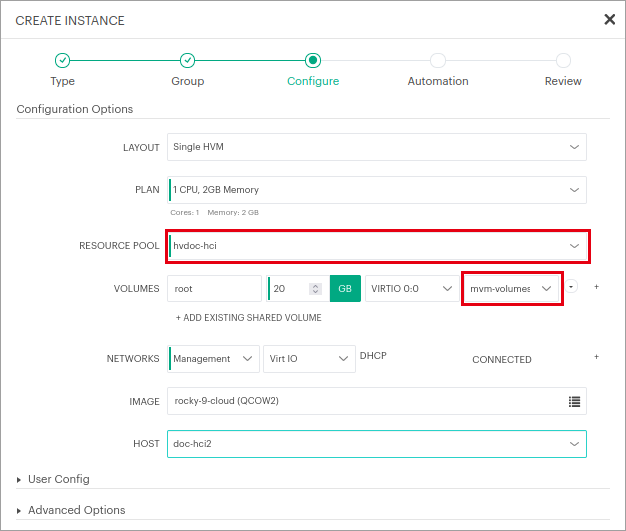
VM のディスクは Ceph の RBD イメージとして作られます。
sudo rbd ls mvm-volumeshvm_2-disk-0-b426fccライブ マイグレーション
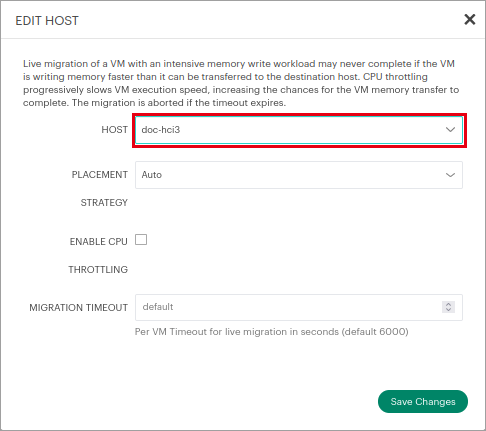
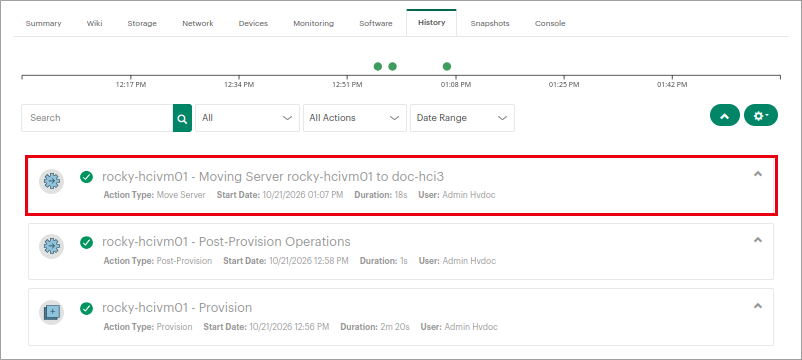
VM の [Actions] → [Manage Placement] で、doc-hci2 から doc-hci3 に移行しました。
| 項目 | 結果 |
|---|---|
| 所要時間 | 17.6 秒(Manager の処理時間) |
| ping の欠落 | 1 回(0.2 秒間隔) |
ストレージ ネットワーク(ボンド)の NIC 障害
VM が動いている doc-hci3 の bond0 のアクティブな NIC(ens19)のリンクを切りました。
grep -E "Currently Active|MII Status" /proc/net/bonding/bond0Currently Active Slave: ens20
MII Status: up
MII Status: down| 項目 | 結果 |
|---|---|
| ボンド | ens20 に切り替わった |
| Ceph | HEALTH_OK のまま(MON・OSD とも 3 台) |
| ゲスト | ping の欠落なし、200 MB の書き込み(direct I/O)が完了 |
ホストの電源断(HA)と Ceph の回復
VM が動いている doc-hci3 の電源を強制的に切りました。
| 経過時間 | 内容 |
|---|---|
| 0 秒 | doc-hci3 の電源を切る |
| 約 2 分 20 秒 | Manager 上で VM の状態が unknown になる |
| 約 4 分 50 秒 | VM が doc-hci1 で起動 |
| 5 分 30 秒 | ゲストに SSH で接続できる |
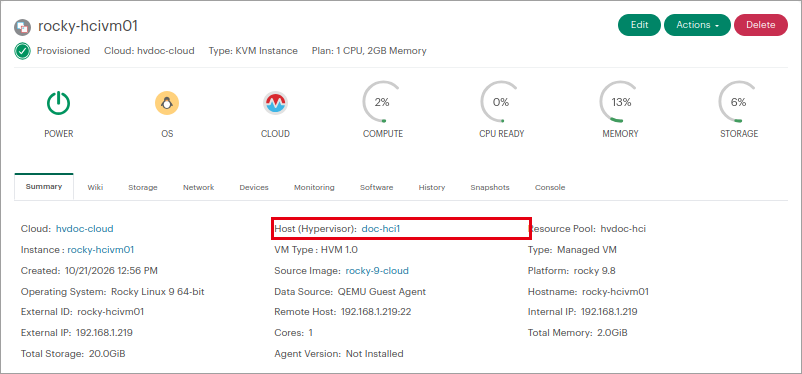
(1) VM のホストが doc-hci1 に変わっています。
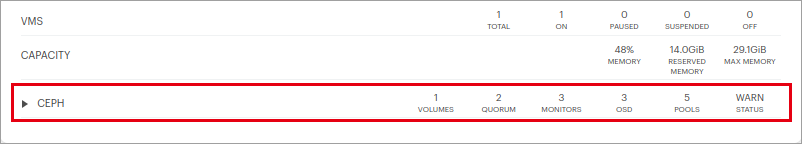
(2) クラスタの [Summary] の [CEPH] は、QUORUM 2/MONITORS 3/OSD 3/WARN になります。
ホストが止まっている間、Ceph は HEALTH_WARN(オブジェクトの 33% がデグレード、MON 2/3、OSD 2/3)になりますが、レプリカ 3・min_size 2 なので VM の読み書きは続きます(200 MB の書き込みが完了)。
    health: HEALTH_WARN
            Degraded data redundancy: 831/2493 objects degraded (33.333%), 173 pgs degraded, 209 pgs undersized
    mon: 3 daemons, quorum doc-hci1,doc-hci2, out of quorum: doc-hci3
    osd: 3 osds: 2 up, 3 in
doc-hci3 を起動すると、電源投入から 51 秒で HEALTH_OK に戻りました(停止中の書き込みが少ないため、回復はすぐ終わりました)。
結果のまとめ
| 試験 | 結果 |
|---|---|
| ライブ マイグレーション | 17.6 秒、ping の欠落 1 回 |
| ボンドの NIC 障害 | 無停止(ping の欠落なし)、Ceph は HEALTH_OK のまま |
| ホストの電源断 | 5 分 30 秒で別のホストで起動。Ceph はデグレードでも読み書き可能 |
| ホストの復旧 | 電源投入から 51 秒で HEALTH_OK |