Proxmox VE 9.2 のクラスタで、仮想マシンを止めずに別のノードへ移すライブマイグレーションと、ノードが故障したときに仮想マシンを別のノードで自動的に起動し直す HA(高可用性)を設定する手順です。HA はノードの強制停止で動作を確かめます。クラスタは【Proxmox VE 9.2】 クラスタ構築手順で構築しています。
この記事の前提
参照した公式ドキュメント
検証環境
| 項目 | 内容 |
|---|---|
| クラスタ | pvedoc-cluster(pve01 / pve02 / pve03 の 3 台) |
| 共有ストレージ | nfs-pvedoc(NFS、すべてのノードで使える) |
| 対象の仮想マシン | 100(debian01)、pve01 で動いている状態 |
準備:ディスクを共有ストレージに移す
HA で別のノードに仮想マシンを起動し直すには、仮想マシンのディスクがすべてのノードから使える共有ストレージにある必要があります。ローカルのストレージ(local-lvm)にあるディスクは、共有ストレージに移します。仮想マシンは動かしたままで移せます。
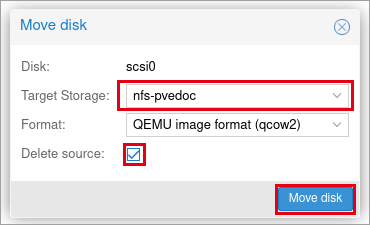
(1) 仮想マシンの [Hardware] でハードディスクを選択し、[Disk Action] → [Move Storage] をクリックします。移動先を指定して [Move disk] をクリックします。
| 項目 | 説明 | 設定値 |
|---|---|---|
| Target Storage | 移動先のストレージです | nfs-pvedoc |
| Format | 移動先でのディスクの形式です | QEMU image format (qcow2) |
| Delete source | 移動が終わったら、元のディスクを削除します(既定:オフ)。オフにすると、元のディスクは「Unused Disk」として残ります | オン |
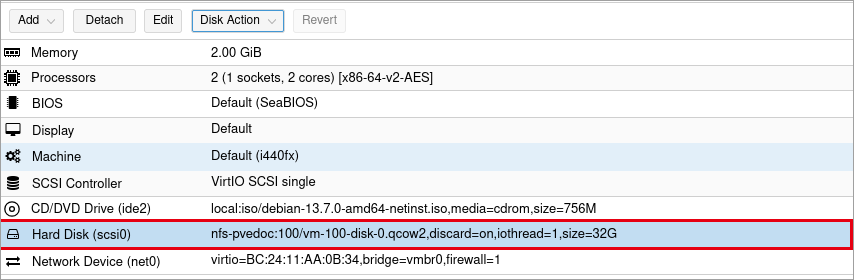
(2) 移動が終わると、ハードディスクの保存先が nfs-pvedoc に変わります。今回は 32 GiB のディスクの移動が約 2 分で終わりました。
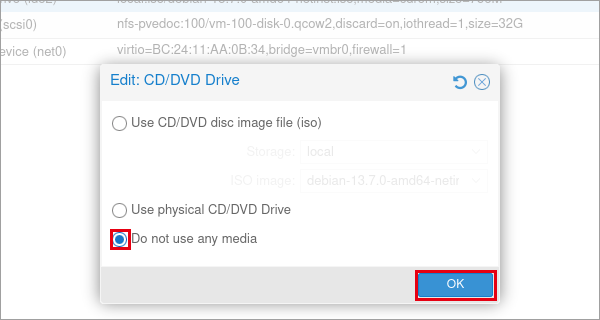
(3) ローカルのストレージの ISO を仮想 CD/DVD ドライブに入れたままだと、ほかのノードに移せません。[CD/DVD Drive] をダブルクリックし、[Do not use any media] を選択して [OK] をクリックします。
スナップショットがあっても、共有ストレージ上ならライブマイグレーションできますが、今回の検証では前の記事で作ったスナップショットを削除してから移動しました。
ライブマイグレーション
(1) 仮想マシンを選択します。クラスタを組むと、右上に [Migrate] が表示されます。[Migrate] をクリックします。

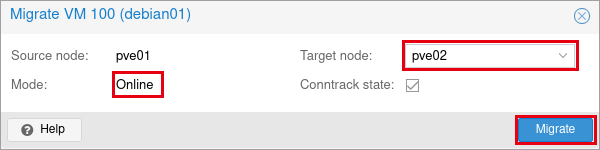
(2) 移行先のノードを選択して [Migrate] をクリックします。
| 項目 | 説明 | 設定値 |
|---|---|---|
| Target node | 移行先のノードです | pve02 |
| Mode | 仮想マシンが動いていれば Online(ライブマイグレーション)、止まっていれば Offline になります(自動で決まります) | Online |
| Conntrack state | ファイアウォールの通信の追跡状態(conntrack)も一緒に移します(既定:オン)。移行後も既存の通信が途切れにくくなります | オン |
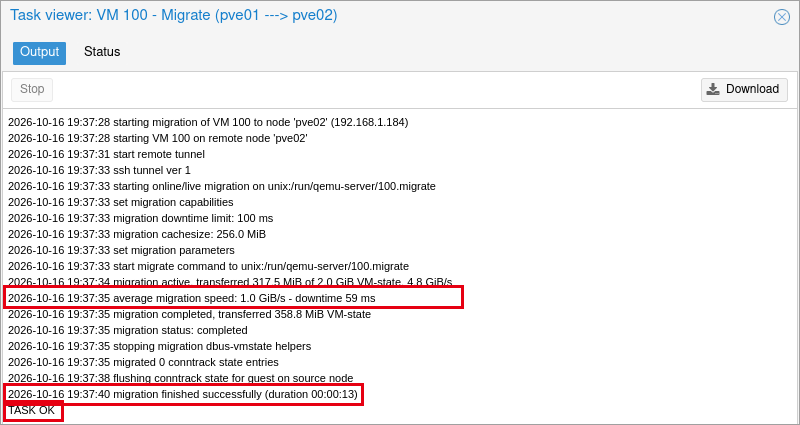
(3) タスクビューアーに「migration finished successfully」と [TASK OK] が表示されたら完了です。今回は全体で 13 秒、仮想マシンが止まった時間(downtime)は 59 ミリ秒でした。
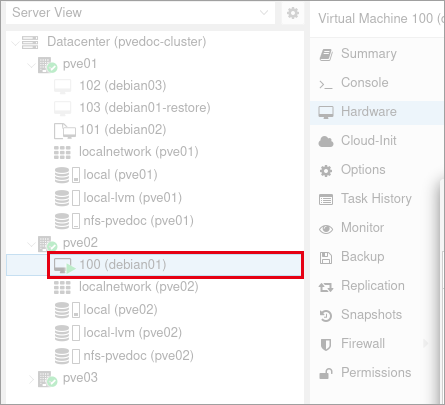
(4) 左のツリーで、仮想マシンが pve02 の下に移ったことを確認します。
HA の設定
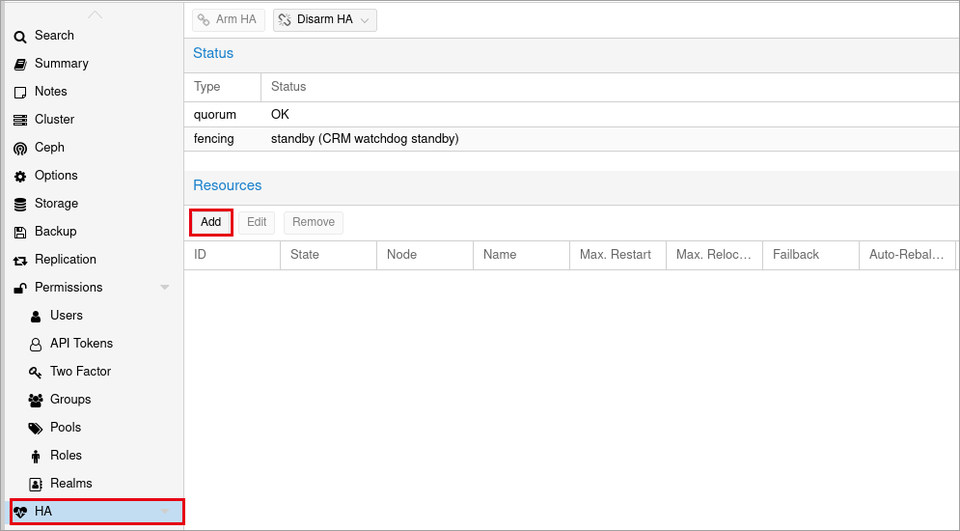
(1) [Datacenter] → [HA] をクリックします。[Status] に quorum(過半数)と fencing(フェンシング)の状態が表示されます。[Resources] の [Add] をクリックします。
(2) HA の対象にする仮想マシンを選択し、[Add] をクリックします。
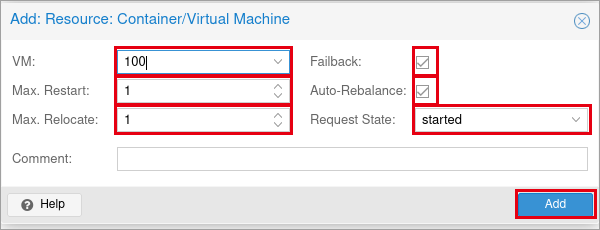
| 項目 | 説明 | 設定値 |
|---|---|---|
| VM | HA の対象にする仮想マシンです | 100 |
| Max. Restart | 同じノードで起動に失敗したときに、起動し直す回数です(既定:1) | 1 |
| Max. Relocate | 起動し直しても失敗したときに、別のノードに移す回数です(既定:1) | 1 |
| Failback | ノードの優先順位を決める Affinity Rules を使っている場合に、優先度の高いノードが復旧したら仮想マシンを戻します(既定:オン) | オン |
| Auto-Rebalance | 負荷に応じて HA の仮想マシンの配置を自動で調整する対象にします(既定:オン)。動作は [CRS Settings] の設定に従います | オン |
| Request State | HA が保とうとする状態です(既定:started=起動した状態)。stopped、disabled(HA で管理しない)、ignored(一時的に HA の管理外)も選べます | started |
| Comment | メモです | 空欄 |
(3) [Status] の fencing が「armed」になり、master(HA の全体を管理するノード)と、各ノードの lrm(ノードごとの HA の管理)が表示されます。[Resources] に vm:100 が started で追加されます。
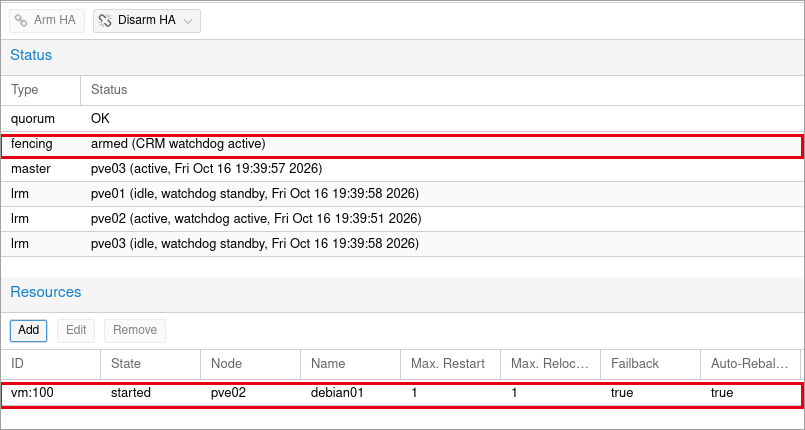
| 表示 | 説明 |
|---|---|
| quorum | クラスタの過半数が取れているかです。OK でないと HA は動きません |
| fencing | armed は、ノードが応答しなくなったらウォッチドッグで強制的に再起動(フェンス)する準備ができている状態です |
| master | HA の判断を行う CRM(Cluster Resource Manager)が動いているノードです |
| lrm | 各ノードで仮想マシンの起動・停止を行う LRM(Local Resource Manager)の状態です。HA の仮想マシンが動いているノードは active になります |
Proxmox VE の HA は、応答しなくなったノードをウォッチドッグで強制的に再起動(自己フェンス)してから、別のノードで仮想マシンを起動します。同じディスクを 2 台のノードが同時に使ってデータが壊れるのを防ぐためです。
動作の確認(ノードの障害)
ここでは pve02 の電源を強制的に切って、ノードの障害を再現しました(今回は入れ子の仮想化のため、pve02 の仮想マシンを強制停止しました)。
(1) 停止から 1 分ほどで、[Status] の pve02 の lrm が「old timestamp – dead?」になり、左のツリーの pve02 に赤い印が付きます。HA はこの時点で、pve02 がフェンスされるのを待ちます。
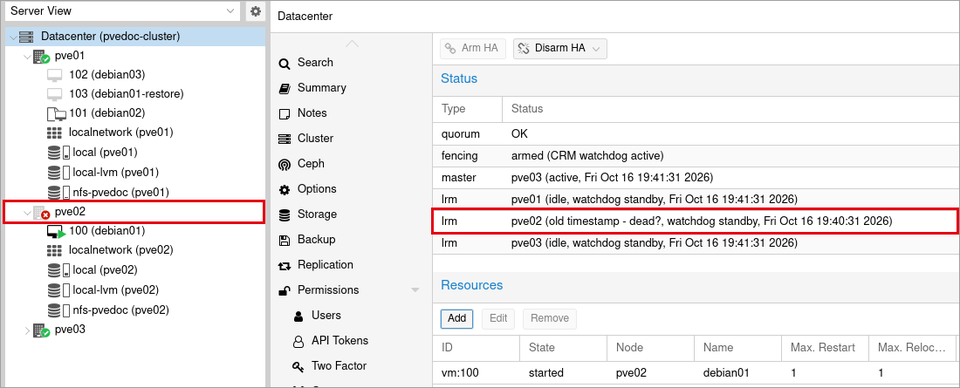
(2) 停止から約 2 分半(今回は 148 秒)で、仮想マシン 100 が pve01 で自動的に起動しました。[Resources] の vm:100 の [Node] が pve01、[State] が started になっていることを確認します。
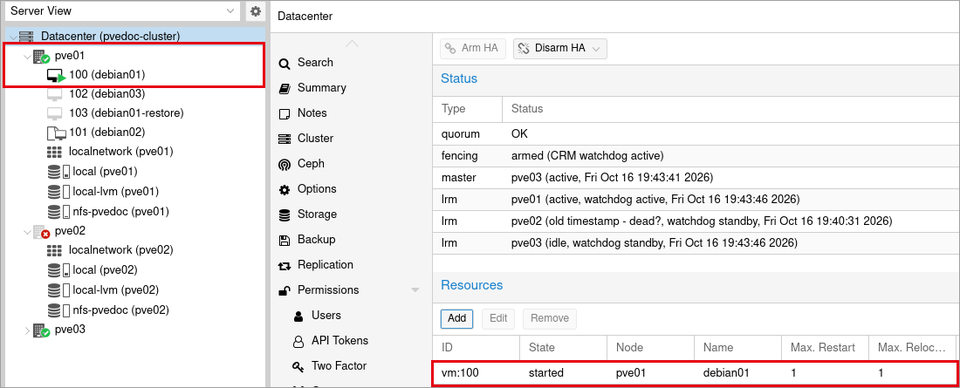
HA で起動し直すのは、電源を切ったときと同じ状態からの起動です。メモリの内容は引き継がれないので、ゲスト OS は再起動したのと同じになります。
止めたノードを起動すると、自動でクラスタに戻ります。Failback がオンでも、Affinity Rules でノードの優先順位を決めていない場合は、仮想マシンは元のノードに戻りません。戻す場合は手動でマイグレーションします。
以上でライブマイグレーションと HA の設定は完了です。

