OKD のクラスタに仮想マシンの機能(OKD Virtualization=KubeVirt)を入れ、仮想マシンのディスク用のストレージ(NFS の CSI ドライバー、iSCSI のマルチパス)と、仮想マシンを LAN に直接つなぐネットワーク(Linux ブリッジ)を設定する手順です。あわせて、ノード障害のときに仮想マシンを別のノードで起動し直す仕組み(Node Health Check・Self Node Remediation)を入れます。
この記事の前提
- 踏み台サーバーの構築とクラスタのインストールが終わっていること
- 踏み台サーバーで
export KUBECONFIG=/root/okd/okdbm/auth/kubeconfigを実行していること(以降の oc コマンドはすべて踏み台サーバーの root で実行します) - 参照: KubeVirt user guide、OKD Documentation
全体の構成
| 用途 | 方式 | 仮想マシンのディスクとしての特徴 |
|---|---|---|
| NFS(踏み台) | csi-driver-nfs(動的に作る) | Filesystem・RWX。イメージの複製やディスクの追加が自動 |
| iSCSI(踏み台、2 系統) | Kubernetes 標準の iSCSI ボリューム(静的な PV) | Block・RWX。ノード側でマルチパス(2 経路)。LUN は事前に作る |
| VM 用ネットワーク | ノードの Linux ブリッジ br-vm(NIC ens21)+bridge CNI | 仮想マシンが LAN の IP アドレスを持ち、移動しても変わらない |
| HA | Node Health Check+Self Node Remediation | 止まったノードを再起動扱いにして、仮想マシンを別のノードで起動し直す |
OKD Virtualization の導入
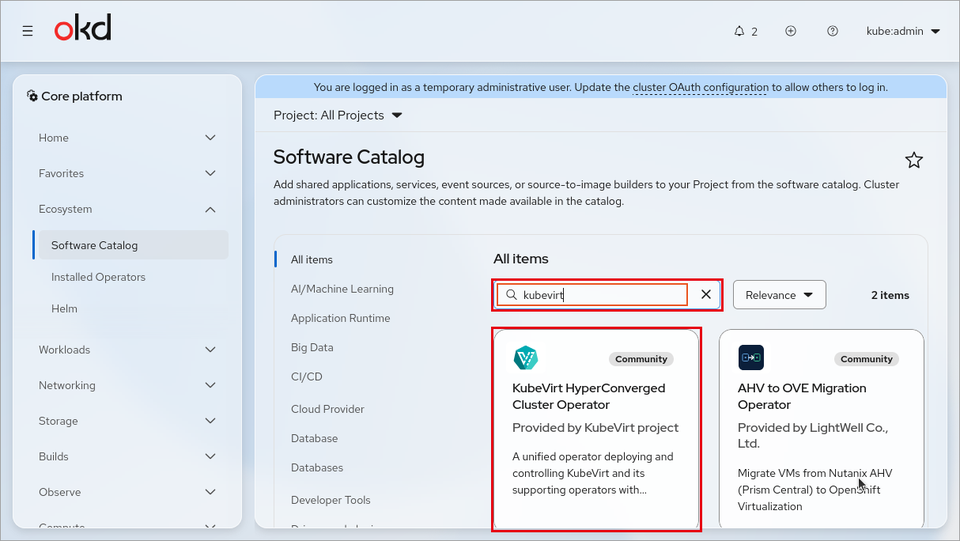
(1) [Ecosystem] → [Software Catalog] で「kubevirt」を検索し、[KubeVirt HyperConverged Cluster Operator](Community)をクリックします。
(2) [Install] をクリックします。
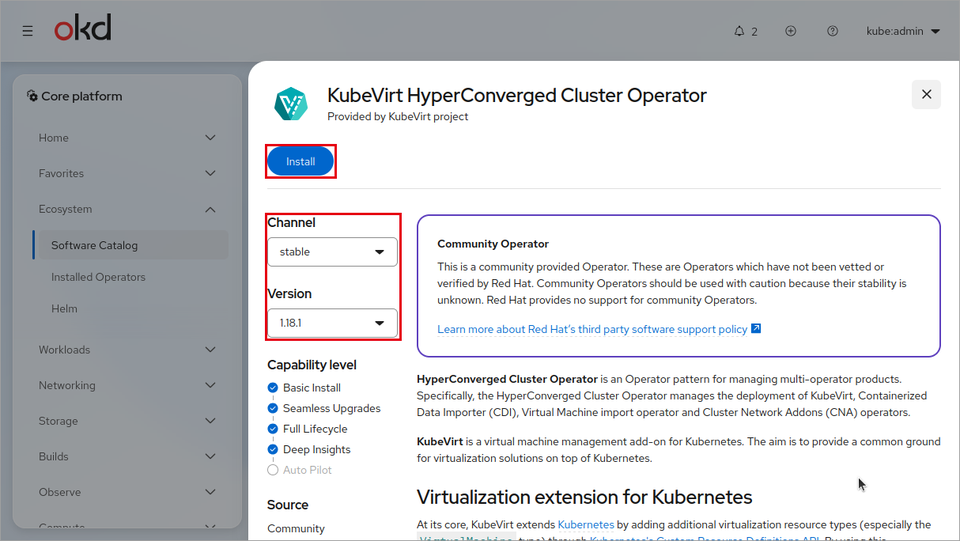
(3) Update channel(stable)、Version、Installation mode(All namespaces)、Installed Namespace(kubevirt-hyperconverged、自動で作られる)を確認して [Install] をクリックします。
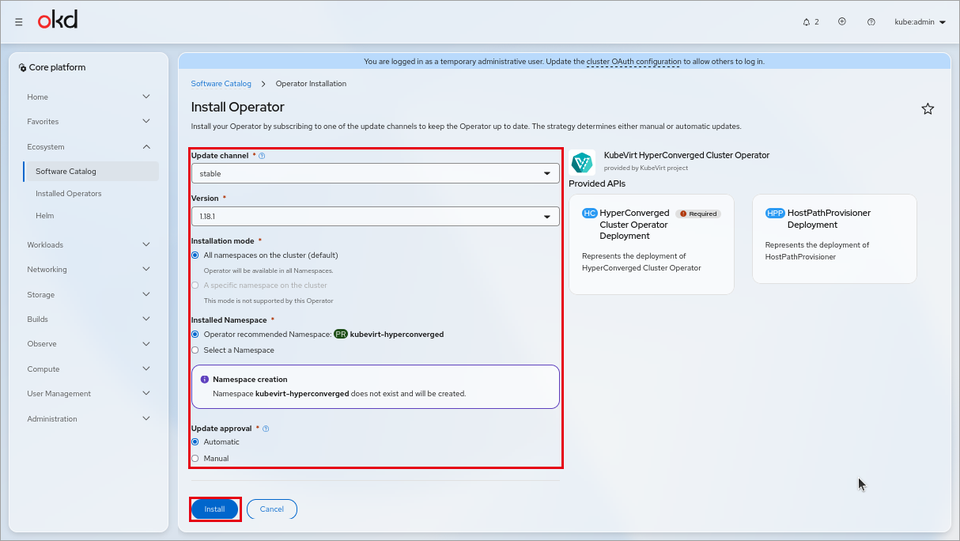
| 項目 | 説明 | 設定値 |
|---|---|---|
| Update channel | 更新の系列 | stable |
| Version | 入れる版 | 1.18.1 |
| Installation mode | オペレーターが見る範囲 | All namespaces(既定) |
| Installed Namespace | オペレーターを置くプロジェクト | kubevirt-hyperconverged(推奨) |
| Update approval | 新しい版を自動で入れるか | Automatic |
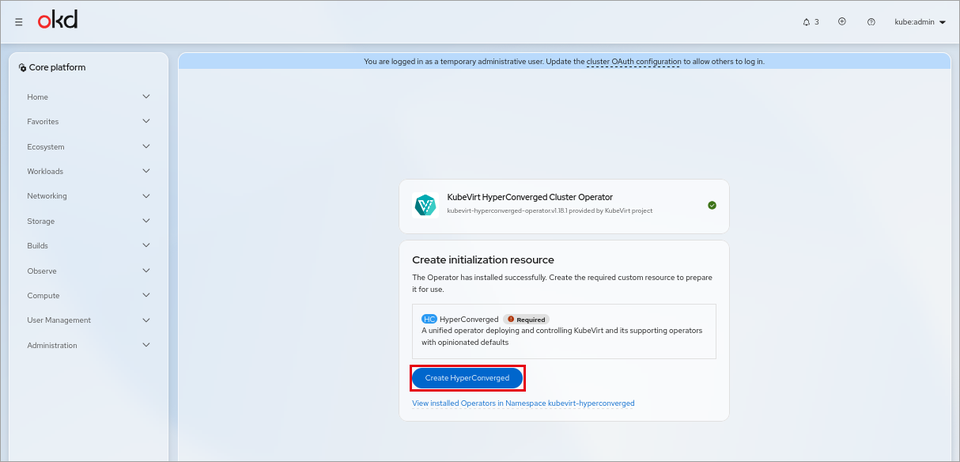
(4) インストールが終わると、[Create HyperConverged] が押せるようになります。クリックします。
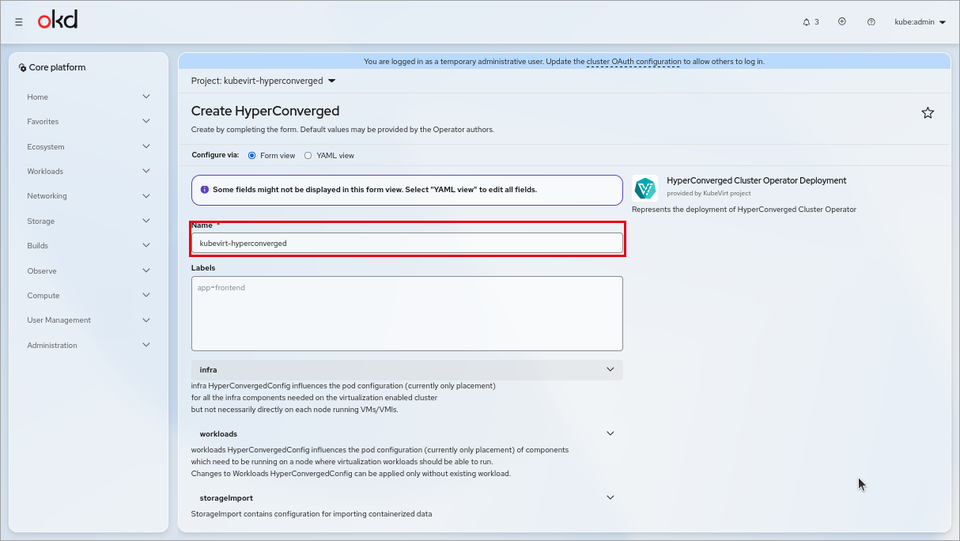
(5) 名前(kubevirt-hyperconverged)のまま、既定値で [Create] をクリックします。数分で、仮想マシンを動かすための部品(virt-handler など)が全ノードに配られます。
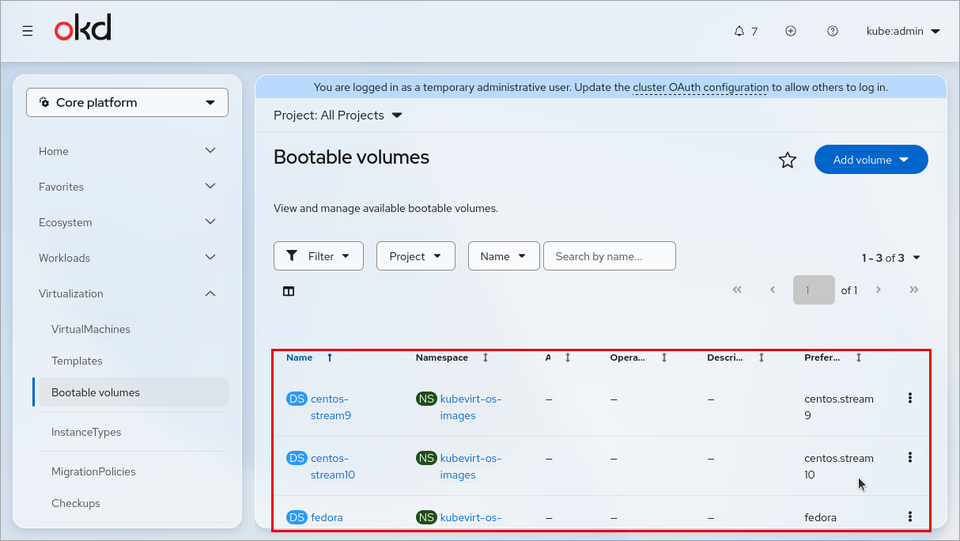
(6) メニューに [Virtualization] と [Migration] が追加されます。[Bootable volumes] には、CentOS Stream 9/10・Fedora の起動用イメージが自動で取り込まれます(既定のストレージ クラスに置かれるため、先に NFS を既定にしておくと、そこに置かれます)。
NFS の CSI ドライバー
# curl -skSL https://raw.githubusercontent.com/kubernetes-csi/csi-driver-nfs/v4.11.0/deploy/install-driver.sh | bash -s v4.11.0 --
# oc adm policy add-scc-to-user privileged -z csi-nfs-controller-sa -n kube-system
# oc adm policy add-scc-to-user privileged -z csi-nfs-node-sa -n kube-system
# oc -n kube-system rollout restart deployment/csi-nfs-controller daemonset/csi-nfs-node
# cat > sc-nfs.yaml <<'EOF'
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: nfs-csi
  annotations:
    storageclass.kubernetes.io/is-default-class: "true"
provisioner: nfs.csi.k8s.io
parameters:
  server: 192.168.1.190
  share: /srv/nfs/okd
reclaimPolicy: Delete
volumeBindingMode: Immediate
allowVolumeExpansion: true
mountOptions:
  - nfsvers=4.1
  - hard
EOF
# oc apply -f sc-nfs.yaml
OKD では、Pod の権限を SCC(Security Context Constraints)で絞っています。CSI ドライバーはノードの /var/lib/kubelet に NFS をマウントするため、コントローラーとノードのサービス アカウントに privileged の SCC を付けないと Pod が作られません。
確認
RWX の PVC を作り、Bound になって、踏み台の /srv/nfs/okd にディレクトリーができることを確認します。
# oc -n default get pvc nfs-test
# ls /srv/nfs/okd/
期待する出力:
NAME       STATUS   VOLUME                                     CAPACITY   ACCESS MODES   STORAGECLASS
nfs-test   Bound    pvc-1552122e-99a8-4d56-99a5-3018b2670be4   1Gi        RWX            nfs-csi
pvc-1552122e-99a8-4d56-99a5-3018b2670be4
iSCSI のマルチパス
ノードの設定(MachineConfig)
OKD のノード(CentOS Stream CoreOS)は、iscsid が無効で、multipath.conf がありません。MachineConfig で有効にします。適用するとノードが 1 台ずつ再起動します。
# MP=$(printf 'defaults {\n    user_friendly_names yes\n    find_multipaths yes\n    skip_kpartx yes\n}\n' | base64 -w0)
# cat > 99-master-iscsi-multipath.yaml <<EOF
apiVersion: machineconfiguration.openshift.io/v1
kind: MachineConfig
metadata:
  name: 99-master-iscsi-multipath
  labels:
    machineconfiguration.openshift.io/role: master
spec:
  config:
    ignition:
      version: 3.4.0
    storage:
      files:
      - path: /etc/multipath.conf
        mode: 0644
        overwrite: true
        contents:
          source: data:text/plain;charset=utf-8;base64,$MP
    systemd:
      units:
      - name: iscsid.service
        enabled: true
      - name: multipathd.service
        enabled: true
EOF
# oc apply -f 99-master-iscsi-multipath.yaml
# oc get mcp master| 設定 | 説明 |
|---|---|
| user_friendly_names | マルチパスのデバイスを mpatha などの名前にする |
| find_multipaths | 2 本以上の経路があるディスクだけをマルチパスにする |
| skip_kpartx | LUN の中のパーティションをノードに割り当てない。仮想マシンのディスクとして使う LUN には必須(下の注意を参照) |
| role: master | 3 台構成で、コントロール プレーンのノードが仮想マシンも動かすため master に適用する |
oc get mcp master の UPDATED が True、UPDATEDMACHINECOUNT が 3 になれば完了です(この環境では約 25 分)。
LUN と ACL(踏み台)
各ノードのイニシエーター名を ACL に登録し、LUN(20 GiB)を作ります。
# for n in master-1 master-2 master-3; do oc debug node/$n -q -- chroot /host cat /etc/iscsi/initiatorname.iscsi | grep -o 'iqn.*'; done
# targetcli /iscsi/iqn.2026-10.lab.hvdoc:okd/tpg1/acls create iqn.1994-05.com.redhat:9465dc72e18
# targetcli /iscsi/iqn.2026-10.lab.hvdoc:okd/tpg1/acls create iqn.1994-05.com.redhat:fce82bc042f5
# targetcli /iscsi/iqn.2026-10.lab.hvdoc:okd/tpg1/acls create iqn.1994-05.com.redhat:afcf50ed87dd
# targetcli /backstores/fileio create name=vm01 file_or_dev=/srv/iscsi/vm01.img size=20G sparse=true write_back=false
# targetcli /iscsi/iqn.2026-10.lab.hvdoc:okd/tpg1/luns create /backstores/fileio/vm01
# targetcli saveconfig
# echo 'vm.min_free_kbytes = 262144' > /etc/sysctl.d/90-iscsi-target.conf
# sysctl -p /etc/sysctl.d/90-iscsi-target.conf
踏み台(ターゲット)のメモリーが 8 GB だと、大きな書き込みでページ キャッシュが空きを使い切り、iSCSI の受信処理が連続した領域を確保できずに失敗しました(dmesg に「iscsi_trx: page allocation failure: order:4」、ノード側に「Logical unit communication failure」の I/O エラー)。
vm.min_free_kbytesで空きを確保すると出なくなりました。
静的な PV(Block・RWX)
LUN を、2 つのポータル(2 系統)を持つ PV にします。ブロック モード(volumeMode: Block)で RWX にすると、ライブ マイグレーション中に移動元と移動先の両方のノードが同じ LUN を開けます。
# cat > pv-iscsi-vm01.yaml <<'EOF'
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: iscsi-static
provisioner: kubernetes.io/no-provisioner
volumeBindingMode: Immediate
---
apiVersion: v1
kind: PersistentVolume
metadata:
  name: iscsi-vm01
spec:
  capacity:
    storage: 20Gi
  volumeMode: Block
  accessModes:
  - ReadWriteMany
  persistentVolumeReclaimPolicy: Retain
  storageClassName: iscsi-static
  iscsi:
    targetPortal: 10.40.81.1:3260
    portals:
    - 10.40.82.1:3260
    iqn: iqn.2026-10.lab.hvdoc:okd
    lun: 0
    readOnly: false
EOF
# oc apply -f pv-iscsi-vm01.yaml
# oc get storageprofile
期待する出力(storageprofile):
NAME           CLAIM                                                      CLONE
iscsi-static   [map[accessModes:[ReadWriteMany] volumeMode:Block]]        copy
nfs-csi        [map[accessModes:[ReadWriteMany] volumeMode:Filesystem]]   copy
iSCSI の LUN で仮想マシンのディスクを作るときの注意(この検証で起きたこと)
– イメージを LUN に複製する作業 Pod(cdi-upload)が、既定のメモリー上限(600 MB)を超えて OOMKilled になりました。HyperConverged の
spec.resourceRequirements.storageWorkloadsで上限を 2 GiB にしました。この項目は API の版 v1beta1 にあるため、oc patch hyperconvergeds.v1beta1.hco.kubevirt.io kubevirt-hyperconverged --type=merge -p '{"spec":{"resourceRequirements":{"storageWorkloads":{"limits":{"cpu":"1","memory":"2Gi"},"requests":{"cpu":"100m","memory":"256Mi"}}}}}'のように版を指定します(版を省くと「unknown field」で無視されます)。– 途中まで書かれた LUN の中のパーティションを、ノードのマルチパスが自動で割り当て(mpatha1〜4)、作業 Pod がデバイスを開けなくなりました(「device or resource busy」)。multipath.conf の
skip_kpartx yesで防げます。– 静的な PV は 1 つの LUN を 1 つのディスクにしか使えません。仮想マシンを増やすたびに LUN と PV を作るか、ストレージ ベンダーの CSI ドライバー(動的に LUN を作れるもの)を使います。
VM 用ネットワーク(LAN への直結)
既定の Pod ネットワーク(masquerade)につないだ仮想マシンは、移動するたびに IP アドレスが変わり、外から直接は届きません。仮想マシンを LAN(192.168.1.0/24)に直接つなぐため、各ノードに VM 用の NIC(ens21)を足し、Linux ブリッジ br-vm を作ります。NMState オペレーターがカタログに無かったため、MachineConfig で NetworkManager の設定ファイルを置きます。
# BR=$(printf '[connection]\nid=br-vm\ntype=bridge\ninterface-name=br-vm\nautoconnect=true\n\n[bridge]\nstp=false\n\n[ipv4]\nmethod=disabled\n\n[ipv6]\nmethod=disabled\n' | base64 -w0)
# PORT=$(printf '[connection]\nid=br-vm-port-ens21\ntype=ethernet\ninterface-name=ens21\ncontroller=br-vm\nport-type=bridge\nautoconnect=true\n' | base64 -w0)
# cat > 99-master-br-vm.yaml <<EOF
apiVersion: machineconfiguration.openshift.io/v1
kind: MachineConfig
metadata:
  name: 99-master-br-vm
  labels:
    machineconfiguration.openshift.io/role: master
spec:
  config:
    ignition:
      version: 3.4.0
    storage:
      files:
      - path: /etc/NetworkManager/system-connections/br-vm.nmconnection
        mode: 0600
        overwrite: true
        contents:
          source: data:text/plain;charset=utf-8;base64,$BR
      - path: /etc/NetworkManager/system-connections/br-vm-port-ens21.nmconnection
        mode: 0600
        overwrite: true
        contents:
          source: data:text/plain;charset=utf-8;base64,$PORT
EOF
# oc apply -f 99-master-br-vm.yaml
# cat > nad-vm-lan.yaml <<'EOF'
apiVersion: k8s.cni.cncf.io/v1
kind: NetworkAttachmentDefinition
metadata:
  name: vm-lan
  namespace: default
  annotations:
    k8s.v1.cni.cncf.io/resourceName: bridge.network.kubevirt.io/br-vm
spec:
  config: |
    {
      "cniVersion": "0.3.1",
      "name": "vm-lan",
      "type": "bridge",
      "bridge": "br-vm",
      "ipam": {},
      "macspoofchk": false,
      "preserveDefaultVlan": false
    }
EOF
# oc apply -f nad-vm-lan.yaml| 項目 | 説明 |
|---|---|
| br-vm.nmconnection | ブリッジ br-vm。ホスト側には IP アドレスを付けない |
| br-vm-port-ens21.nmconnection | ens21 を br-vm のポートにする |
| NetworkAttachmentDefinition vm-lan | 仮想マシンの NIC をつなぐ先(bridge CNI で br-vm へ)。ここでは default プロジェクトに作る |
| resourceName | br-vm があるノードにだけ仮想マシンを置くための目印(bridge-marker が付ける) |
MachineConfig の適用で、ノードは 1 台ずつ再起動します。動いている仮想マシンは、再起動するノードからライブ マイグレーションで退避されます。
ノード障害への備え(Node Health Check・Self Node Remediation)
KubeVirt は、ノードが止まっても、そのノードの仮想マシンを自動では別のノードで起動しません(止まったノードで動き続けている可能性があり、同じディスクを二重に使うと壊れるため)。Node Health Check がノードの異常を見つけ、Self Node Remediation が「そのノードは再起動した(仮想マシンは止まった)」ことを保証すると、仮想マシンが別のノードで起動し直します。
(1) Community Operators から node-healthcheck-operator と self-node-remediation を入れます(コンソールの Software Catalog からでも、Subscription の YAML でもかまいません)。
# cat <<'EOF' | oc apply -f -
apiVersion: v1
kind: Namespace
metadata:
  name: openshift-workload-availability
---
apiVersion: operators.coreos.com/v1
kind: OperatorGroup
metadata:
  name: workload-availability
  namespace: openshift-workload-availability
---
apiVersion: operators.coreos.com/v1alpha1
kind: Subscription
metadata:
  name: node-healthcheck-operator
  namespace: openshift-workload-availability
spec:
  channel: stable
  name: node-healthcheck-operator
  source: community-operators
  sourceNamespace: openshift-marketplace
---
apiVersion: operators.coreos.com/v1alpha1
kind: Subscription
metadata:
  name: self-node-remediation
  namespace: openshift-workload-availability
spec:
  channel: stable
  name: self-node-remediation
  source: community-operators
  sourceNamespace: openshift-marketplace
EOF
# oc -n openshift-workload-availability get csv
期待する出力(抜粋):
node-healthcheck-operator.v0.12.0   Node Health Check Operator - Community Edition       0.12.0   Succeeded
self-node-remediation.v0.13.0       Self Node Remediation Operator - Community Edition   0.13.0   Succeeded
(2) コントロール プレーン(この構成では仮想マシンを動かすノード)を対象に NodeHealthCheck を作ります。
# cat <<'EOF' | oc apply -f -
apiVersion: remediation.medik8s.io/v1alpha1
kind: NodeHealthCheck
metadata:
  name: nhc-control-plane
spec:
  minHealthy: 51%
  selector:
    matchExpressions:
    - key: node-role.kubernetes.io/control-plane
      operator: Exists
  remediationTemplate:
    apiVersion: self-node-remediation.medik8s.io/v1alpha1
    kind: SelfNodeRemediationTemplate
    namespace: openshift-workload-availability
    name: self-node-remediation-automatic-strategy-template
  unhealthyConditions:
  - type: Ready
    status: "False"
    duration: 60s
  - type: Ready
    status: Unknown
    duration: 60s
EOF
# oc get nodehealthcheck nhc-control-plane -o jsonpath='{.status.phase} {.status.healthyNodes}/{.status.observedNodes}{"\n"}'
期待する出力:
Enabled 3/3| 項目 | 説明 | 設定値 |
|---|---|---|
| minHealthy | これより健全なノードが少ないときは復旧しない(クラスタ全体の障害で全ノードを再起動しないため) | 51%(3 台中 2 台) |
| selector | 対象のノード | control-plane のノード |
| remediationTemplate | 復旧の方法。Self Node Remediation の自動の戦略 | automatic-strategy |
| unhealthyConditions | ノードの Ready が False または Unknown のまま 60 秒続いたら異常とみなす | 60s(検証のため短め。既定は 300s) |
Self Node Remediation は、ノードのウォッチドッグ(/dev/watchdog)でノードを確実に再起動させます。この検証の仮想マシン(ノード)にはウォッチドッグ デバイスが無いため、ソフトウェアでの再起動(isSoftwareRebootEnabled)が使われます。物理サーバーでは iTCO_wdt などのウォッチドッグがあることを確認します。